


Sam Altman’ın yerinde olsam


Sam Altman, kişisel bilgisayarlarda duran belleğin veri merkezlerinde daha verimli kullanılabileceğini söylüyor. Gerekçesi, herkesin kendi bilgisayarında yapay zekâ çalıştırmak için bellek bulundurması yerine, aynı kaynakların bulutta daha yoğun kullanılması.
Bu görüşü okuyunca aklıma gelen ilk şey, hesabın dışında bırakılan değişkenler oldu.
Bugün kişisel yapay zekâdan vazgeçmemizi gerektiren bir bellek krizi ortaya konmuş değil. Gelecekte yaşanabilecek bir darboğazdan hareketle, çözümü bugünden bütün kaynakları veri merkezlerinde toplamakta aramayı doğru bulmuyorum. Üretimin, bellek yönetiminin, modellerin ve verinin temsil biçimlerinin aynı kalacağını nereden biliyoruz?
Teknolojinin geleceğini hesaplarken en sık yapılan hatalardan biri, bugünkü üretim ve kullanım yöntemlerini sabit kabul etmek. Daha fazla yapay zekâ kullanılırsa daha fazla bellek gerekir; o halde daha fazla bellek üretmek ve bunları veri merkezlerine koymak gerekir. Böyle bir hesap kurulabilir. Ancak aradaki bütün mühendislik ihtimallerini dışarıda bırakırsanız ulaşacağınız sonuç da baştan belli olur.
Geleneksel üretim yöntemlerinin dışına çıkan bir bellek mimarisi geliştirilebilir. Bellek yönetimi değişebilir. Veriyi daha az yer kaplayacak biçimde temsil eden bir sıkıştırma yöntemi, bugün gerekli gördüğümüz kapasitenin bir bölümünü gereksiz hale getirebilir. Modeller aynı işi daha az kaynakla yapmayı öğrenebilir. Her bir gelişmenin hız, kalite ve maliyet üzerindeki etkisi ayrıca değerlendirilir. Fakat bütün bu parametreleri yok sayarak geleceğin ihtiyacını yalnızca bugünkü bellek tüketiminin üzerine çarpan koyarak hesaplayamayız.
Üstelik bunların hepsi uzak geleceğe ait ihtimaller de değil. Google’ın Turbo Quant çalışması, yapay zekâ modellerinin kullandığı KV önbelleğindeki veriyi sıkıştırarak bellek ihtiyacını azaltmayı hedefleyen somut bir örnek. Böyle bir araştırma tek başına bütün bellek sorunlarını çözmez. Ancak sorunun çözümünde üretilecek çip sayısının yanında, mevcut belleğin nasıl kullanıldığının da belirleyici olacağını gösterir.
Gmail’in ortaya çıktığı dönemi hatırlayalım.
E-posta hizmetlerinde depolama alanı kullanıcıların başlıca sorunlarından biriydi. Posta kutusu doluyor, yeni ileti alabilmek için eskileri silmek gerekiyordu. Google, 2004’te Gmail’i 1 GB alanla sundu. 2005’te kapasiteyi artırdı ve sürekli yükselen depolama sayacını kullanıcıların önüne koydu.
O sayaç, kapasitenin büyüdüğünü gösterirken kullanıcıya bir güven de veriyordu: Alan yetiştirme işi hizmeti sağlayanın sorumluluğundaydı. Kullanıcı, her yeni e-postanın karşılığında hangisini sileceğini düşünmek zorunda kalmayacaktı.
Google’ın kullanıcı kazanmasında bu yaklaşımın payını küçümseyemeyiz. Şirket, sektörün önemli bir kapasite sorununa çözüm getirerek tercih edilmek için güçlü bir gerekçe oluşturdu.
E-posta depolamasıyla yapay zekânın çalışma belleği farklı teknolojiler. Gmail örneğinden çıkardığım ders ise her ikisine de uygulanabilir: Bugünün kapasite sınırı, yarının ürününü tanımlayan değişmez bir doğa yasası değildir. Teknoloji şirketinden beklenen, bu sınırın etrafına iş modeli kurmanın yanında sınırı aşacak yolları da geliştirmesidir.
Yapay zekâda da yönün giderek kullanıcı cihazlarına doğru genişleyeceğini düşünüyorum. İnsanlar kendi belgeleriyle, kendi verileriyle, kendi bilgisayarlarında çalışmak isteyecek. Her işlemi başka bir şirketin altyapısına göndermeden yapabilmek; bağlantı, erişim ve hizmet koşullarına daha az bağımlı olmak isteyecek.
Bunun veri merkezlerinin bugünkü yapı içindeki ağırlığını zayıflatacağı kanaatindeyim. Özellikle kullanıcıya cevap üretme işinde, yerel donanımın ve daha verimli modellerin payı büyüdükçe merkezi altyapının tek seçenek olma gücü azalacak.
Sam Altman’ın da bu yönü gördüğünü düşünüyorum. OpenAI’nın yerelde çalıştırılabilen gpt-oss modellerini yayımlamış olması, şirketin bu ihtiyacı fark ettiğini düşündüren bir adım. Benim önerim, o adımı herkesin kullanabileceği bir ürüne dönüştürmesi.
Ben Sam Altman’ın yerinde olsam hemen bir yerel ChatGPT çıkarırım.
Kullanıcı uygulamayı indirir, donanımına uygun modeli kurar, belgeleriyle kendi bilgisayarında çalışır. Güncellemeyi, kurulumu ve günlük kullanımı ChatGPT’den beklediği kolaylıkla yapar. Kendi cihazında gerçekleşen işlemle dışarıya gönderilen işlemi de açıkça görür ve kararını kendisi verir.
Böylece OpenAI, kullanıcının kendi bilgisayarında yapay zekâ çalıştırma isteğini karşılayan şirket olur. Bir modelin dosyalarını yayımlamanın ötesine geçerek, yerel yapay zekâyı geniş kitleler için kullanılabilir hale getirir.
Bu yönelimin önünde durmaya çalışmanın sektörel sonucu da var. Yapay zekâya erişimin birkaç büyük veri merkezi işletmecisinin elinde yoğunlaşması, tekelleşmenin önünü açar. Kullanıcının alternatifini geliştirmek, kendi donanımını kullanmak ve gerektiğinde hizmet sağlayıcısını değiştirmek için sahip olduğu imkânlar daralır.
Yapay zekânın yaygınlaşmasını savunurken, onu çalıştırabilme imkânının da yaygınlaşmasını savunmak gerekir. Kullanıcının hesaplama gücü üzerindeki kontrolü, verimlilik hesabına katılması gereken bir değerdir.
Ben bu hareketin durdurulabileceğine inanmıyorum. Daha verimli modeller, farklı bellek kullanımları ve kullanıcıların bağımsız çalışma isteği aynı yönde ilerliyor. OpenAI’nın önündeki tercih, bu dönüşümün ne kadar erken parçası olacağı.
Sam Altman’ın yerinde olsam, insanların bilgisayarlarındaki belleğin nerede daha verimli kullanılacağını tartışmak yerine, o bellekte çalıştırmak isteyecekleri ChatGPT’yi geliştiririm.
Yeni gelişmelere dair bildirimler alıp haberleri kaydetmek ister misiniz?
- BildirimlerYeni gelişmeler ve son dakika
- KaydetHaberler uygulamada saklanır
Çok Okunanlar
Cumhurbaşkanı Erdoğan: İzmir'de 16 kardeşimiz vefat etti
İzmir Valiliği’nden HABAŞ'taki patlamaya dair açıklama
Cumhurbaşkanı Erdoğan'dan 'fon soruşturması'na dair yeni açıklama
Moskova’dan Abu Dabi görüşmeleri öncesi Avrupa’ya suçlama
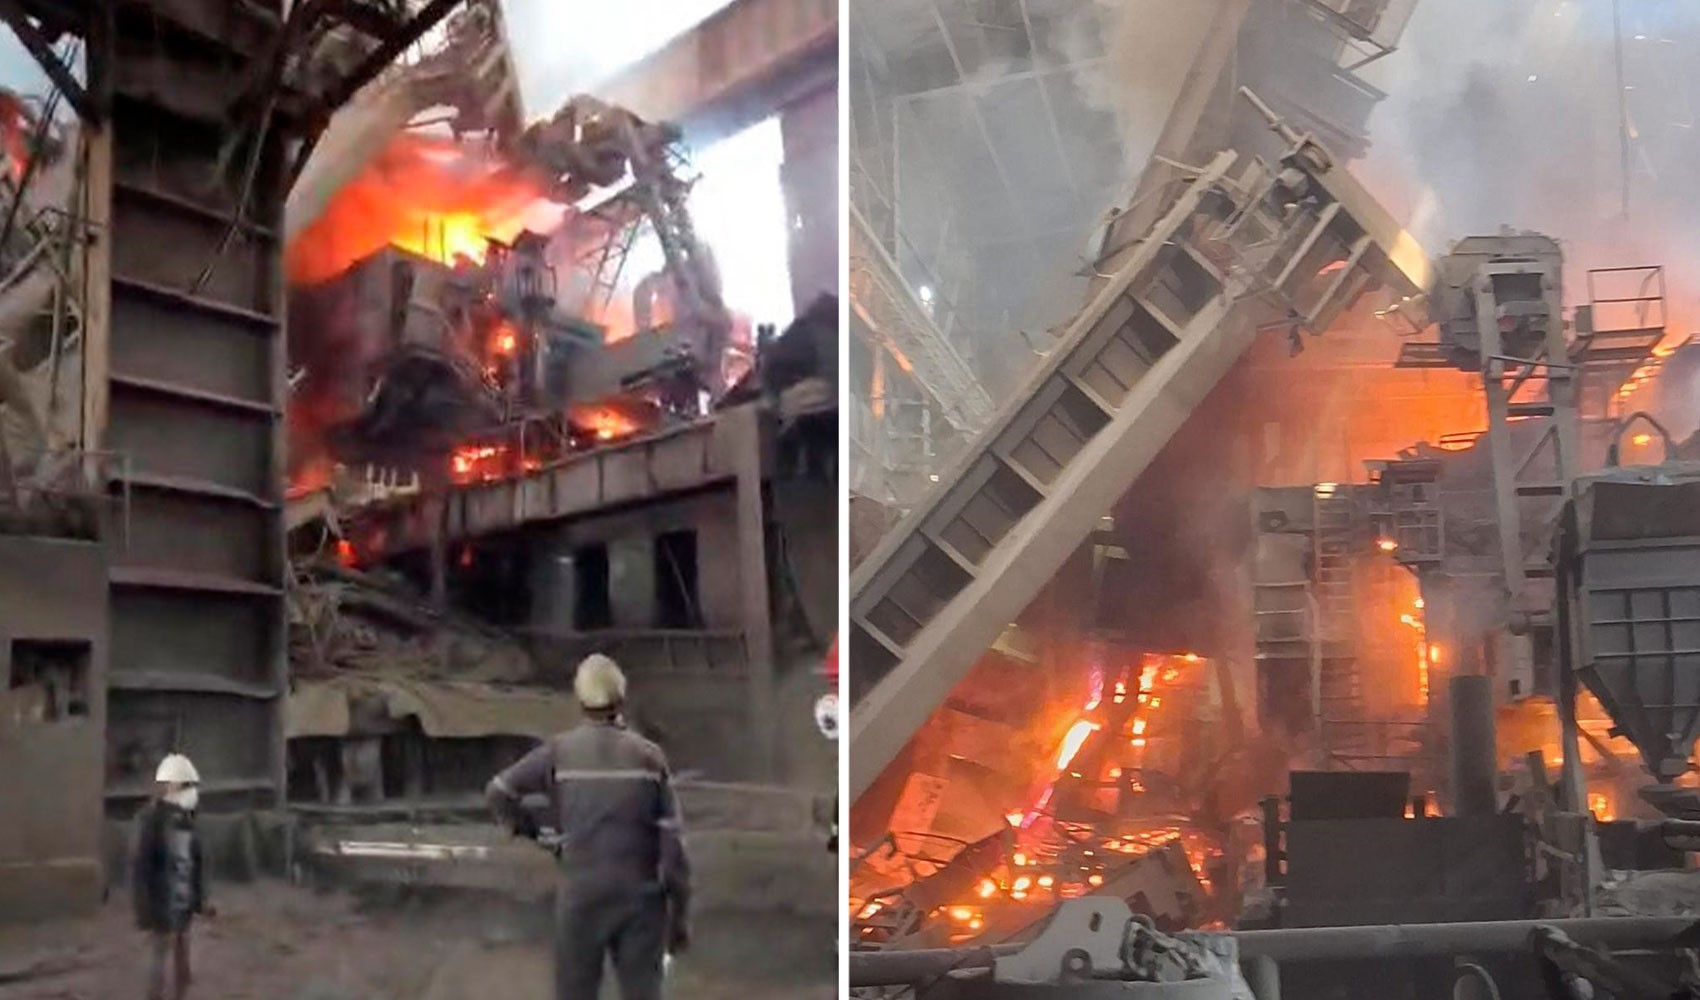
İzmir'deki patlamada can kaybı 6'ya yükseldi!
Marmaris’te yeni yıl festivali 17 Aralık’ta başlıyor
Elveda büyük solak
İzmir'de patlamanın olduğu fabrikada bir kişi kendisini ateşe verdi
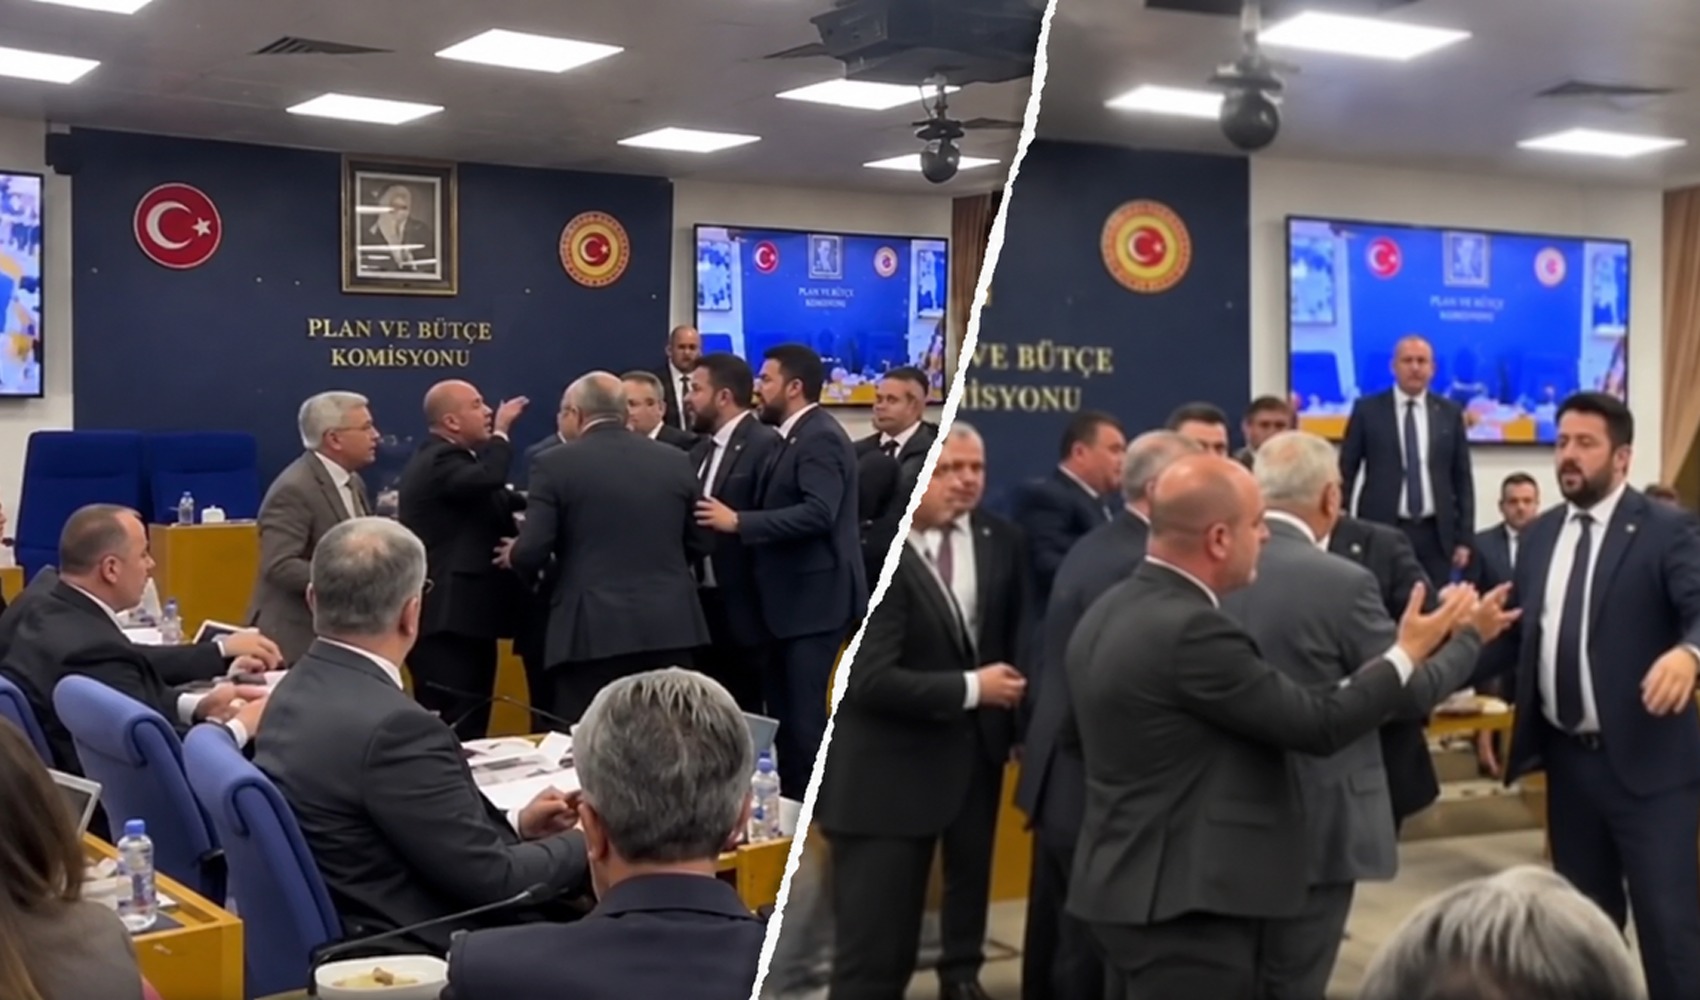
TBMM'de bütçe görüşmelerinde gerginlik
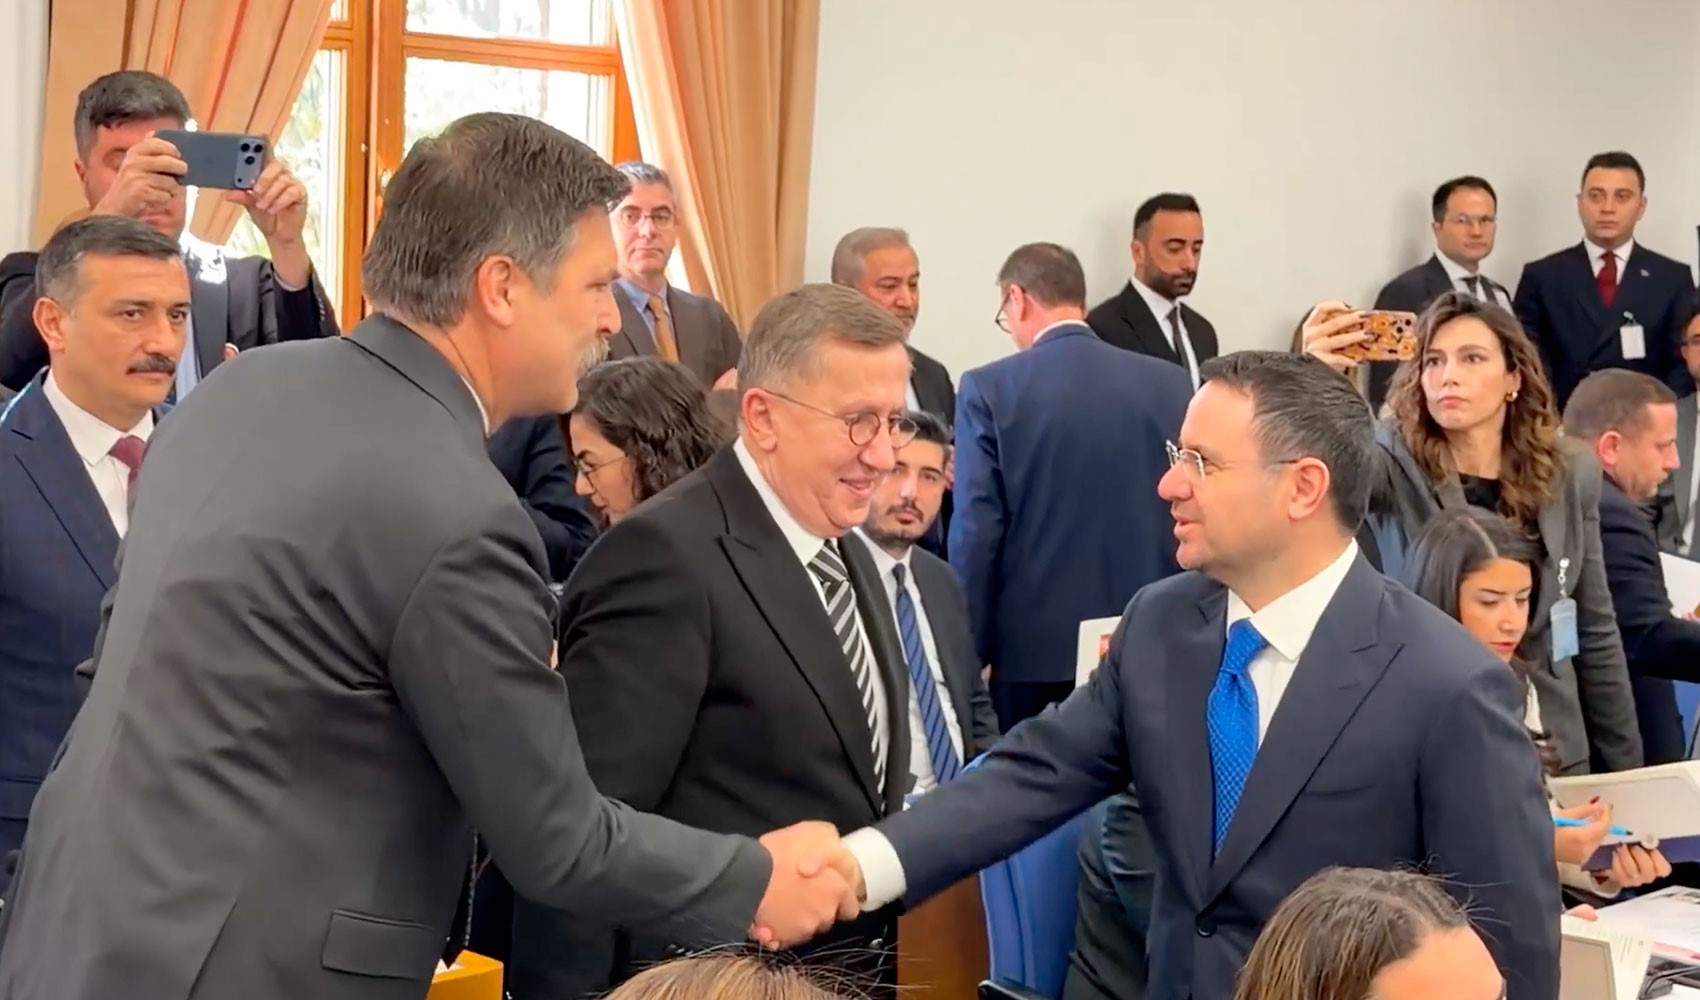
Akın Gürlek salona girdi, YENİ Partililer dışarı çıktı